CDN·방화벽 실수로 구글봇 막힌다? 점검 체크리스트
클라우드플레어 등 CDN·방화벽 설정 실수로 구글봇이 막혀 순위가 급락하는 사례가 늘고 있습니다. 확인법과 해제 절차를 실전 체크리스트로 정리했습니다.
결론부터 말하면 이렇다. 어제까지 잘 나오던 페이지가 갑자기 검색에서 사라졌다면, 콘텐츠 문제가 아니라 CDN이나 방화벽 설정 하나가 구글봇을 막고 있을 가능성부터 확인해야 한다. 클라우드플레어 같은 CDN·보안 서비스를 켜둔 사이트에서 특히 자주 벌어지는 일이다.
문제는 이런 차단이 대부분 의도한 게 아니라 보안 설정의 부작용으로 생긴다는 점이다. 관리자는 스팸 봇이나 무차별 공격을 막으려 방화벽 규칙을 강화했을 뿐인데, 그 규칙이 구글봇까지 함께 걸러낸다. 콘텐츠를 아무리 잘 써도 로봇이 페이지에 들어오지 못하면 색인에서 빠지고, 순위는 통째로 사라진다.
이런 사고가 최근 들어 더 자주 보이는 이유도 있다. AI 크롤러가 폭증하면서 CDN·호스팅 업체들이 기본 봇 방어 수준을 계속 강화하고 있고, 그 강화된 규칙이 검색 크롤러까지 함께 걸러내는 경우가 늘었다. 보안을 강화할수록 검색 노출이 함께 흔들릴 위험도 커진 셈이다. 특히 트래픽이 몰리는 시즌을 앞두고 보안 설정을 급하게 손보는 쇼핑몰·서비스 사이트에서 이런 사고가 자주 나온다.
이 글의 핵심
- CDN·방화벽 설정 실수로 구글봇이 막히면 콘텐츠와 무관하게 순위가 급락한다
- 구글 서치 콘솔의 크롤링 통계 보고서(설정 > 크롤링 통계)로 차단 여부를 가장 먼저 확인한다
- 클라우드플레어의 Bot Fight Mode·WAF 관리형 규칙·수동 IP 차단이 대표적인 원인이다
- User-Agent만 보고 봇을 구분하면 안 된다 — 역방향 DNS로 진짜 구글봇인지 검증해야 한다
- 차단을 풀었다고 순위가 바로 회복되는 것은 아니며, 재크롤링까지 며칠에서 몇 주가 걸릴 수 있다
구글봇이 막혔는지 어떻게 확인하나?
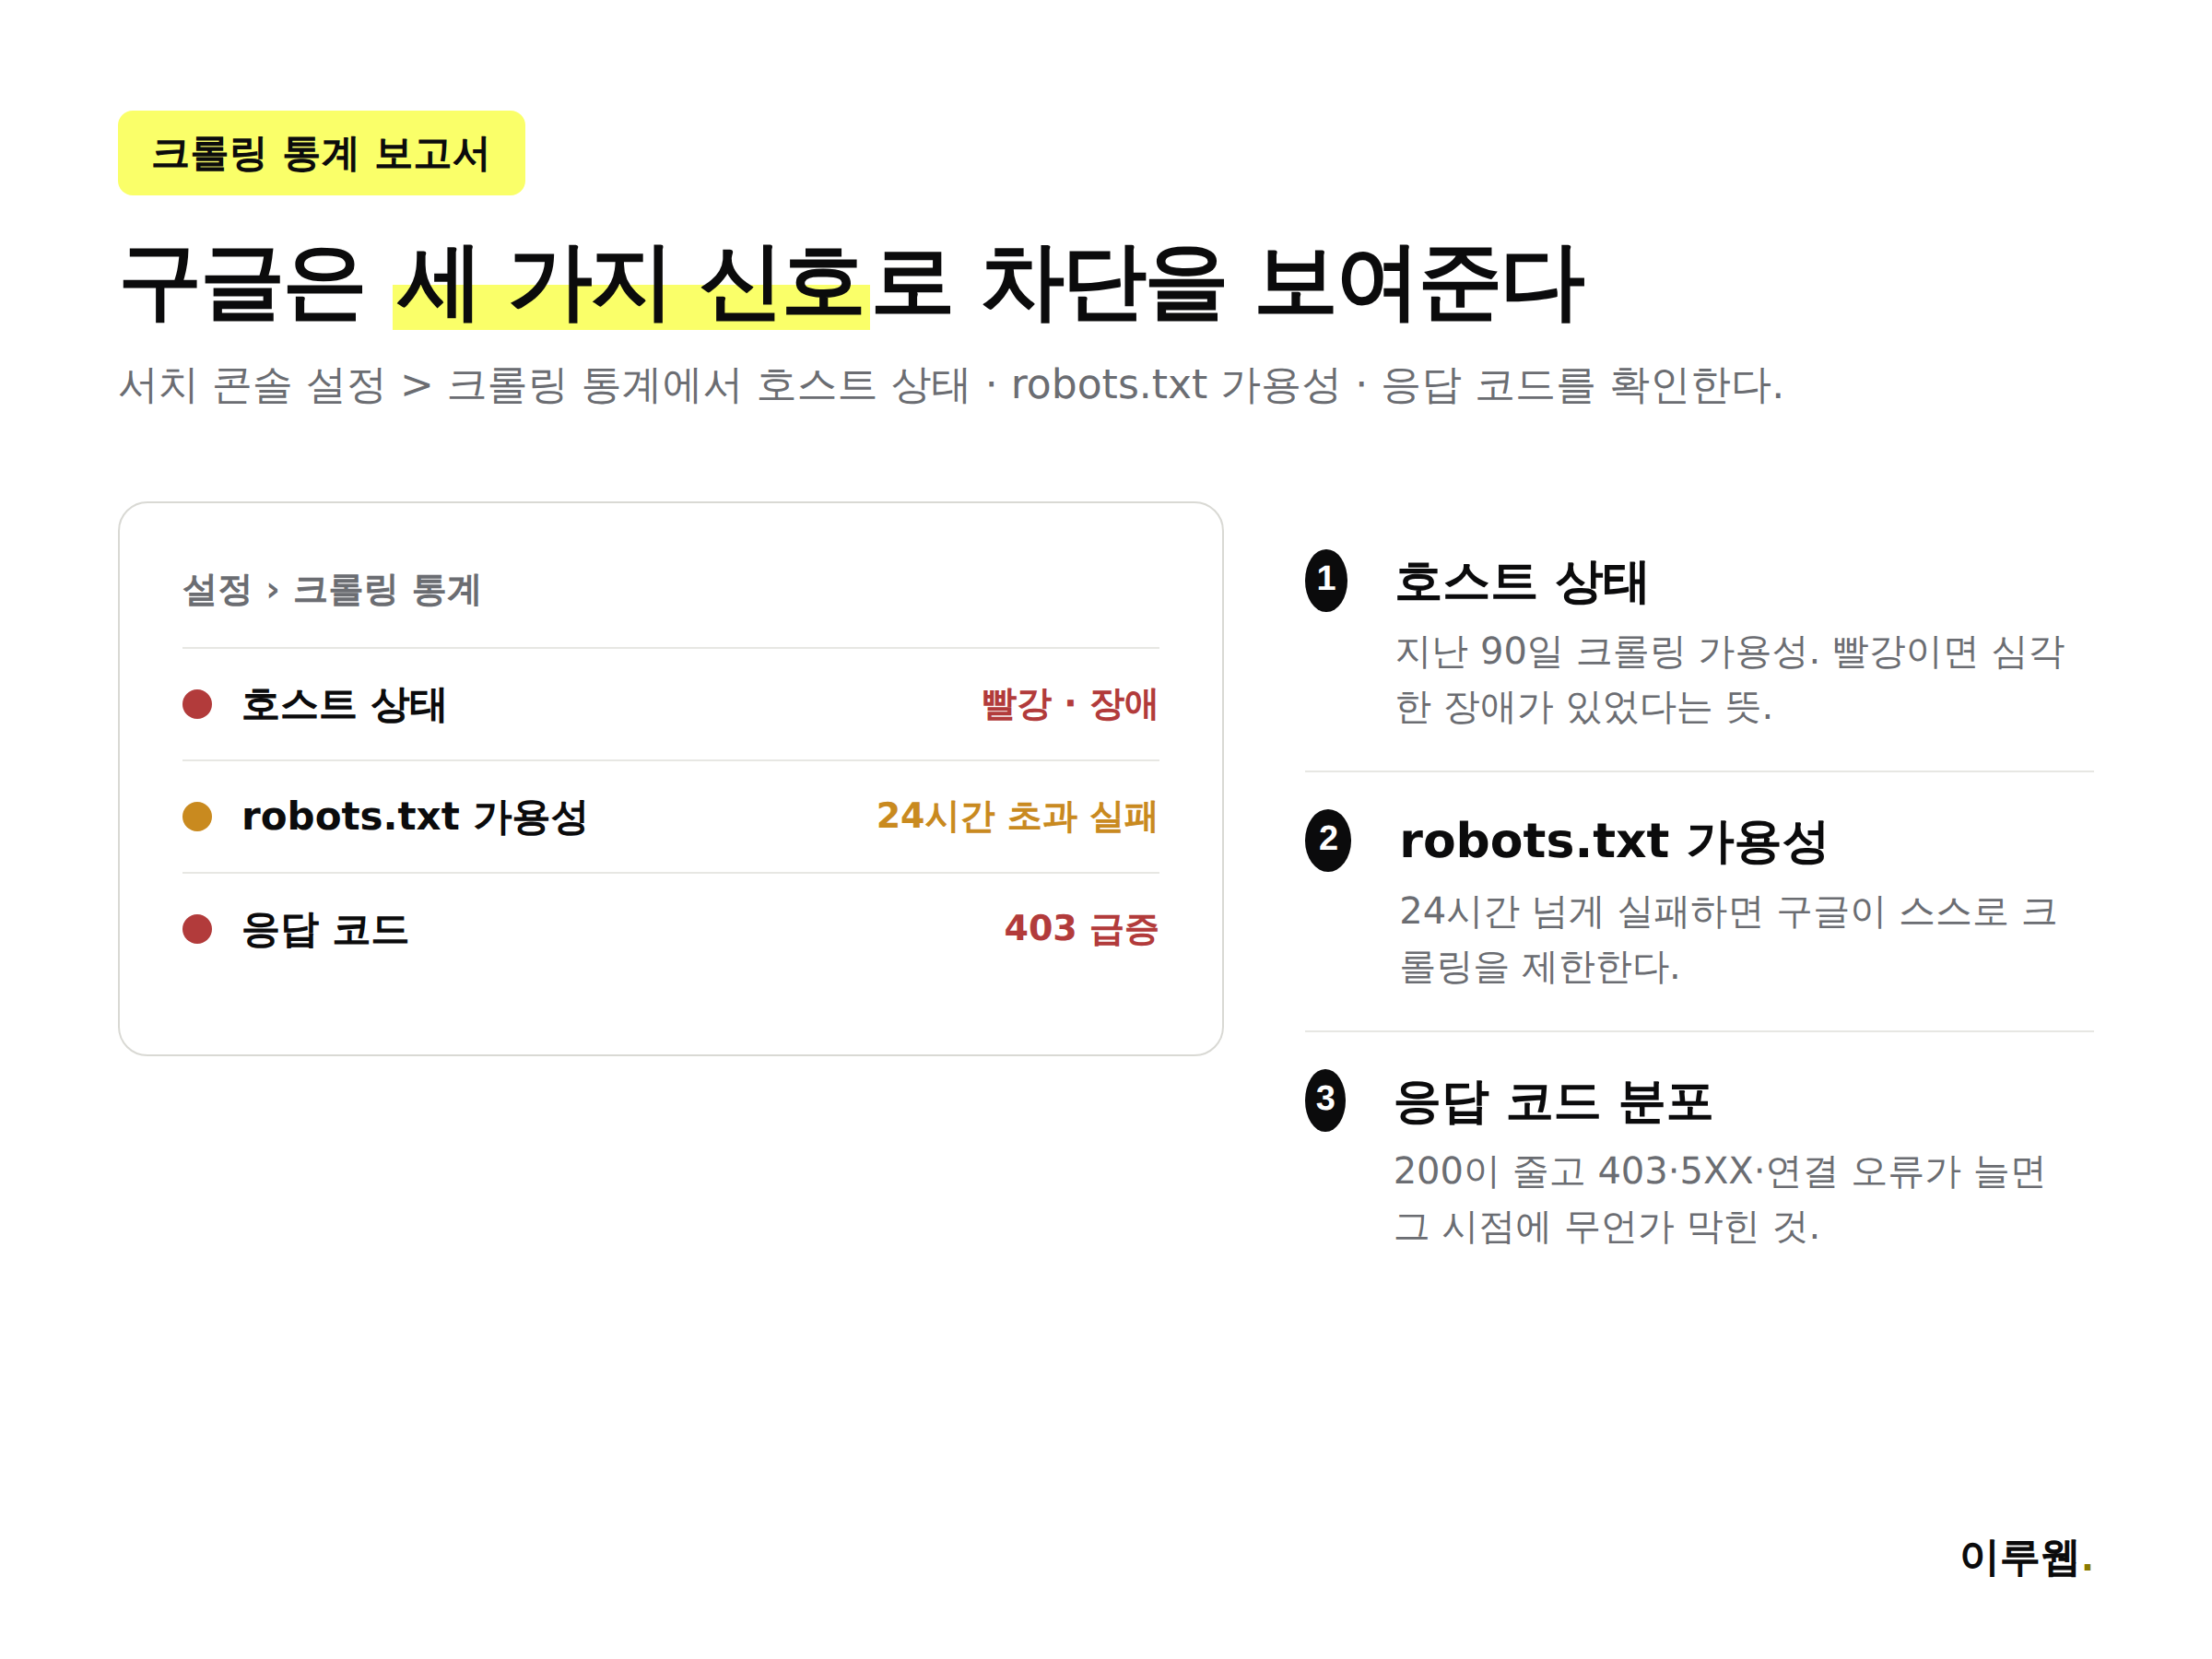
가장 빠른 방법은 구글 서치 콘솔의 크롤링 통계 보고서를 여는 것이다. 메뉴 경로는 설정 > 크롤링 통계다. 여기서 지난 90일간의 크롤링 가용성을 한눈에 볼 수 있다.
이 보고서에서 볼 것은 크게 세 가지다.
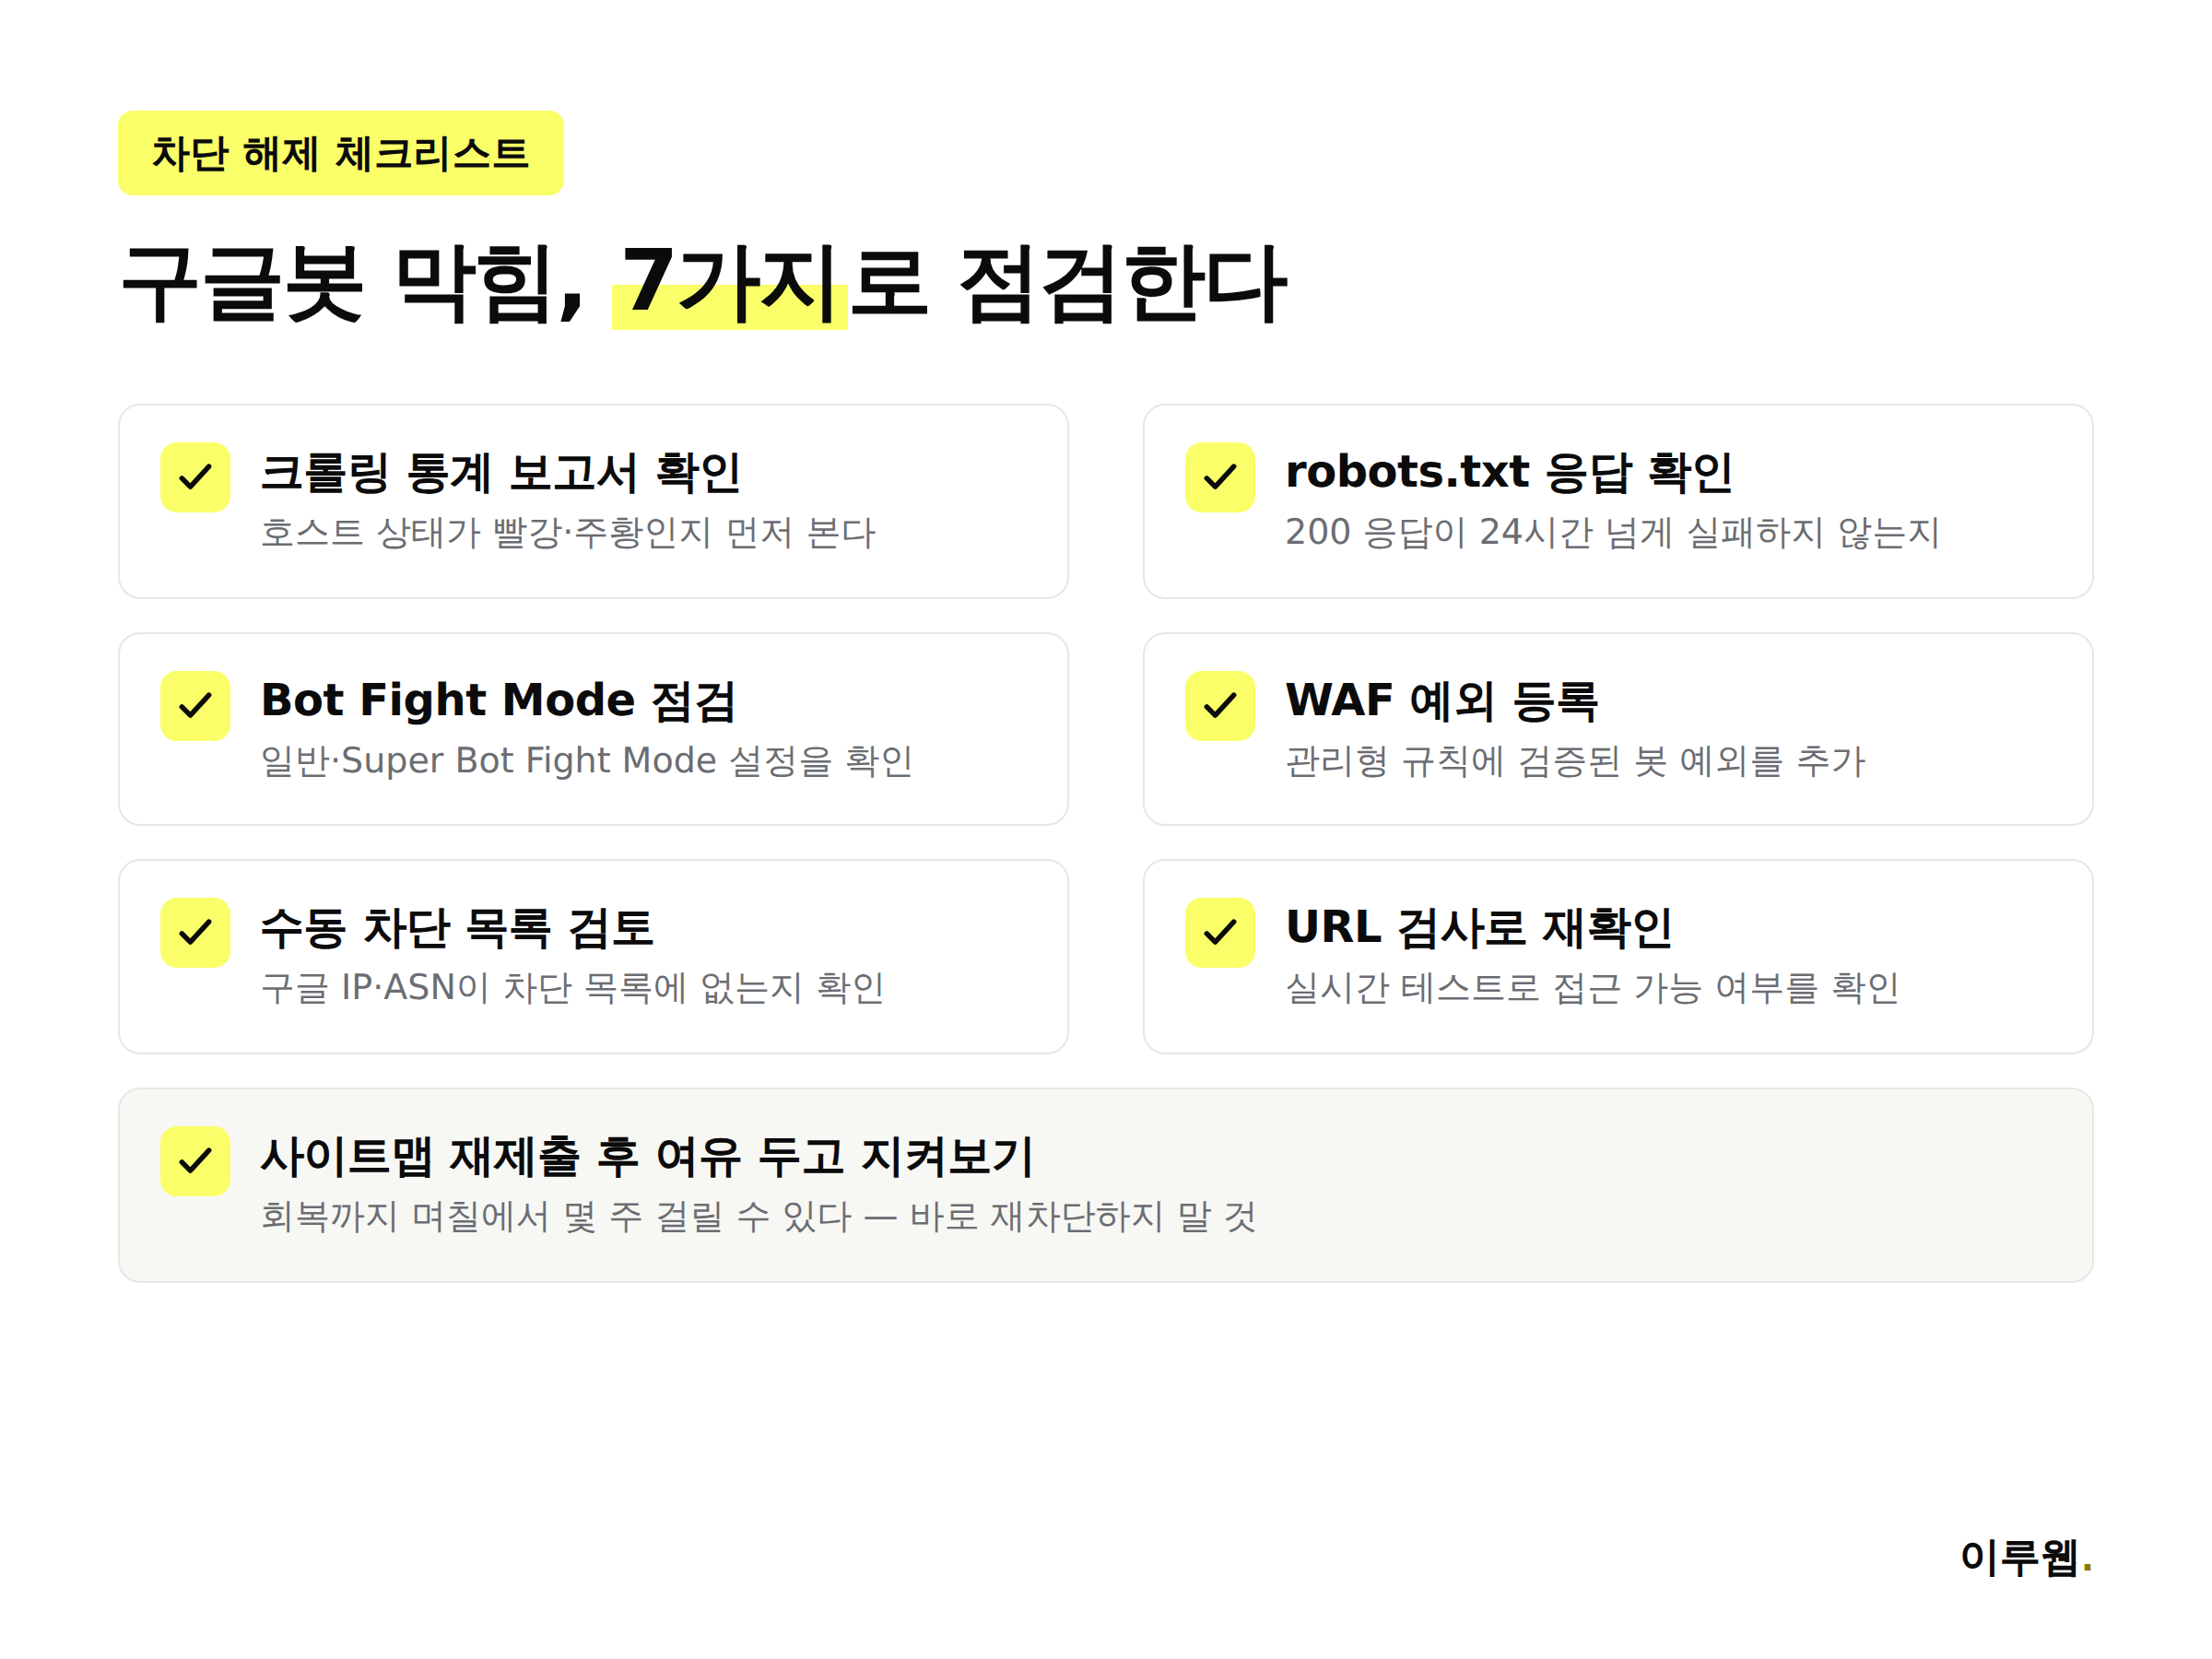
첫째, 호스트 상태다. 초록·주황·빨강 세 단계로 표시되며, 빨강이면 심각한 크롤링 장애가 있었다는 뜻이다. 둘째, robots.txt 가용성이다. robots.txt가 정상 응답을 못 주는 상태가 24시간 넘게 이어지면 구글이 아예 크롤링을 제한하기 시작한다. 셋째, 응답 코드 분포다. 200(정상)이 줄고 403(접근 거부)이나 5XX(서버 오류), 연결 오류가 늘었다면 그 시점에 무언가 막힌 것이다.
크롤링 통계 보고서에서 특정 날짜부터 403·연결 오류가 급증했다면, 그 날짜에 CDN·방화벽·보안 플러그인 설정을 바꾼 기록이 있는지부터 대조해 보는 것이 순서다.
보조 확인 수단으로는 URL 검사 도구의 "실시간 테스트"가 있다. 특정 페이지 하나를 골라 지금 이 순간 구글봇이 접근할 수 있는지 바로 확인할 수 있어, 크롤링 통계 보고서보다 반응이 빠르다. 색인 생성 보고서에서 "크롤됨-현재 색인되지 않음"이나 "발견됨-현재 색인되지 않음" 상태가 갑자기 늘어난 것도 같은 신호로 볼 수 있다.
관련 항목별로 더 자세한 확인법은 크롤링 통계 보고서 완전 가이드에서 다뤘다.
robots.txt가 정상인데도 왜 계속 막히나?
여기서 많은 관리자가 착각한다. robots.txt 파일을 브라우저로 열어보고 "Allow: /"가 그대로 있으니 문제없다고 결론짓는 것이다. 하지만 CDN·방화벽에서 걸리는 차단은 요청이 원본 서버(그리고 그 안의 robots.txt 파일)에 도달하기도 전에, 네트워크 앞단에서 끊기는 방식으로 벌어진다.
즉 robots.txt 파일 자체는 한 글자도 바꾸지 않았는데 크롤링이 막혔다면, 오히려 그 사실 자체가 원인이 파일이 아니라 CDN·방화벽 같은 네트워크 앞단에 있다는 신호다. robots.txt는 "어디를 크롤링해도 되는지" 알려주는 안내판일 뿐이고, WAF나 봇 방어 기능은 그 안내판을 보기도 전에 방문객을 문 앞에서 돌려보내는 경비원 역할을 한다. 안내판(robots.txt) 점검과 경비원(CDN·방화벽) 점검은 완전히 별개로 해야 한다.
robots.txt를 아무리 다시 확인해도 문제가 없다면, 다음 확인 대상은 파일이 아니라 그 앞을 지키는 CDN·보안 서비스의 대시보드다.
CDN·방화벽에서 구글봇이 막히는 흔한 원인은 무엇인가?
가장 흔한 원인은 클라우드플레어의 Bot Fight Mode(봇 방어 모드) 기능이다. 악의적인 자동화 트래픽을 막으려는 기능이 정상적인 검색 크롤러까지 자동화된 요청으로 오인해 함께 걸러낸다.
유료 플랜의 "Super Bot Fight Mode"도 비슷하다. "확실히 자동화된 것(Definitely automated)" 항목을 차단으로 설정해 두면, 이 분류 로직이 구글봇 요청 일부를 함께 걸러내는 사례가 실제로 보고돼 있다.
이 외에도 다음과 같은 원인이 흔하다.
| 원인 | 어떻게 문제가 되나 |
|---|---|
| WAF 관리형 규칙(Managed Rules) | 워드프레스 보안 규칙 세트 등이 정상 크롤러 요청 패턴까지 공격으로 오인 |
| 수동 IP·ASN 차단 목록 | 관리자가 구글 소유 IP 대역을 스팸 IP로 착각해 직접 차단 목록에 추가 |
| 챌린지(캡차) 페이지 | 의심 트래픽에 캡차를 띄우는 설정이 로그인 없는 크롤러에도 노출돼 통과 불가 |
| 요청 속도 제한(Rate Limiting) | 짧은 시간에 여러 페이지를 도는 크롤링 패턴을 과도한 요청으로 판단해 차단 |
| AI 크롤러 차단 정책의 "학습 차단" | 구글봇이 검색·학습을 동시에 수행하는 혼합형 크롤러로 분류돼, 학습 차단 규칙에 함께 걸림 |
WAF 관리형 규칙이 걸리는 대표 상황도 알아두면 좋다. 구글봇은 사람과 달리 자바스크립트를 매번 완전히 실행하지 않고, 짧은 시간에 여러 페이지를 연속으로 요청하며, 쿠키를 유지하지 않은 채 매 요청을 새로 보낸다. 그런데 이런 행동 패턴은 공격 봇의 특징과도 겹친다. 워드프레스 보안 플러그인이나 일반 보안 규칙 세트가 "쿠키 없음 + 빠른 연속 요청 + 자바스크립트 미실행"을 기준으로 자동화 트래픽을 잡아내도록 설정돼 있으면, 정상적인 구글봇 크롤링 패턴도 같은 기준에 걸려 차단당한다.
마지막 항목(AI 크롤러 차단 정책)은 별도로 다룰 만큼 사례가 많다. 클라우드플레어가 새 도메인에 적용하는 AI 크롤러 기본 정책에서 "학습(Training) 차단"을 켜면 구글봇도 막힐 수 있는데, 이 주제는 클라우드플레어 AI 크롤러 정책과 구글봇에서 자세히 풀었다.
실제 사고는 보통 어떤 순서로 발견되나?
전형적인 흐름은 이렇다. 관리자가 스팸·공격 트래픽이 늘었다고 느껴 보안 설정을 강화한다. 이후 며칠간은 사이트가 정상으로 보인다 — 이미 방문 중인 사용자에게는 캐시된 페이지가 그대로 보이고, 신규 방문자 수 감소도 다른 요인(계절적 변동 등)으로 오인하기 쉽다.
문제가 눈에 보이기 시작하는 것은 보통 1–2주 뒤 검색 유입이 눈에 띄게 줄어들 때다. 이 시점에 많은 관리자가 콘텐츠 품질이나 구글 알고리즘 업데이트를 먼저 의심한다. 실제로는 크롤링 통계 보고서를 열어봐야 원인이 드러나는데, 이 단계를 건너뛰고 콘텐츠를 고치거나 새 글을 계속 쓰는 데 시간을 쓰다가 문제를 더 늦게 발견하는 경우가 많다. 순위가 갑자기, 전체적으로 빠졌다면 콘텐츠보다 먼저 크롤링 상태를 확인하는 것이 순서를 아끼는 방법이다.
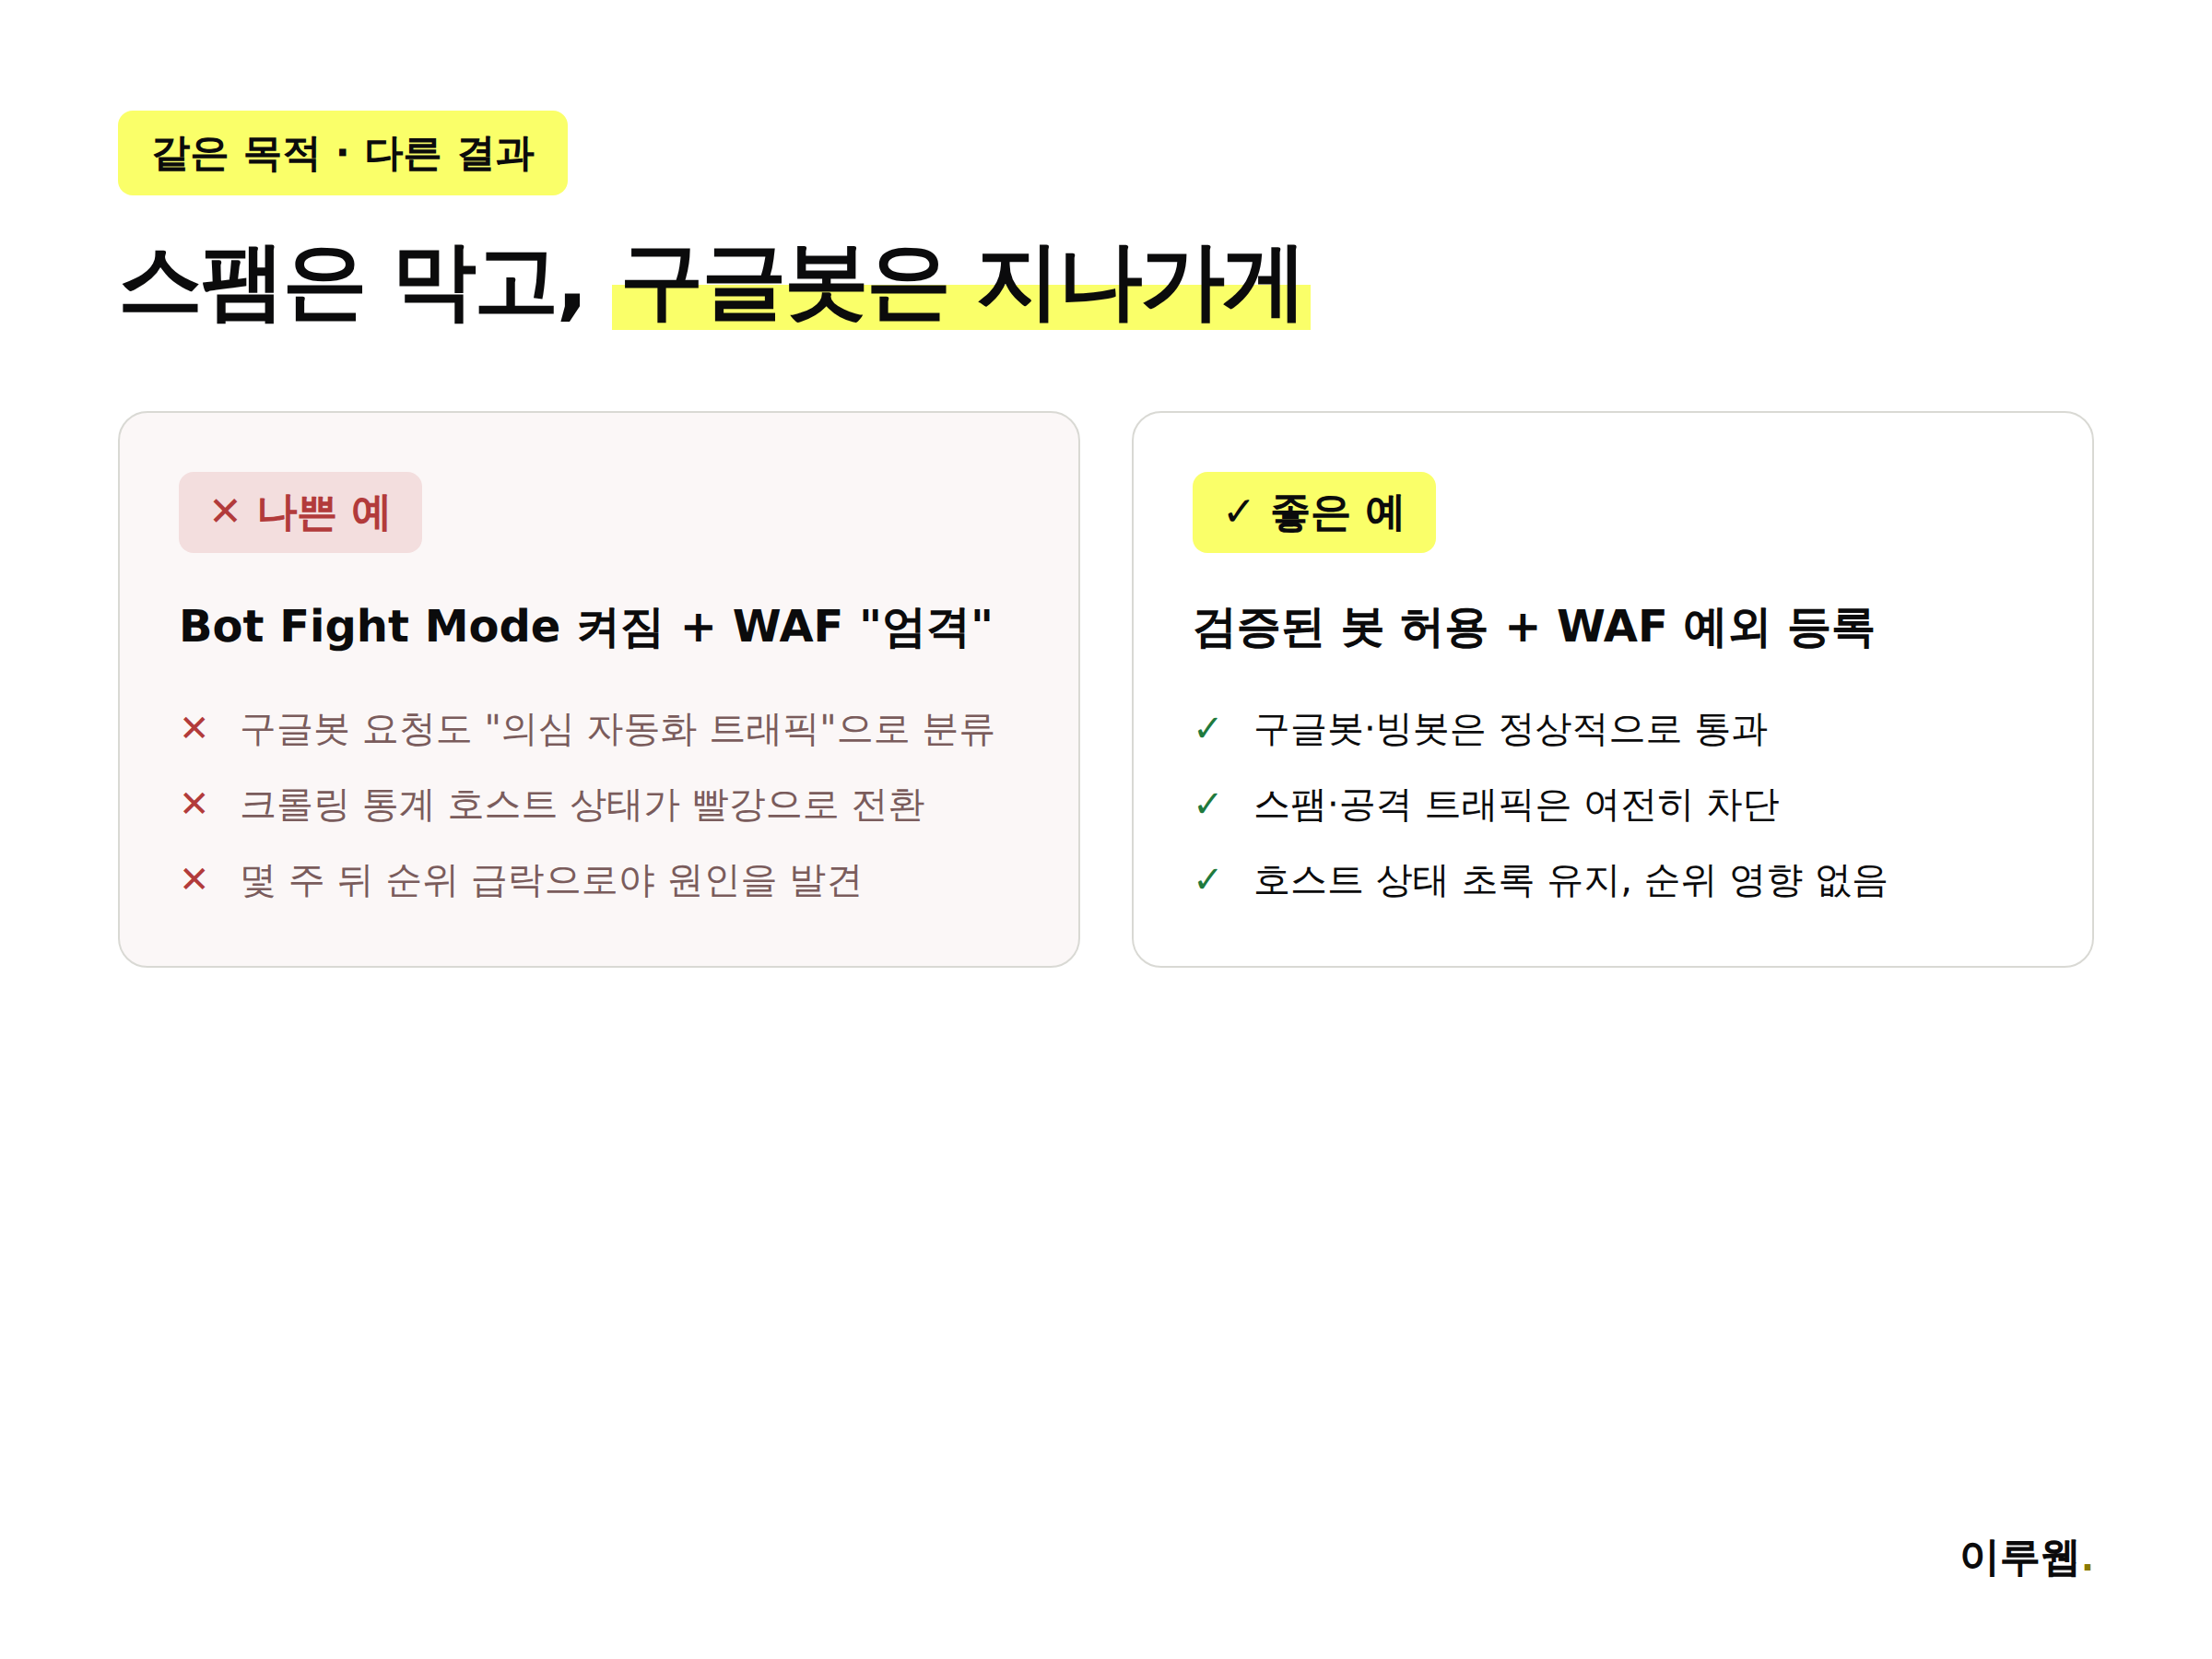
나쁜 예: 관리자가 스팸 로그인 시도를 막으려 클라우드플레어 "Bot Fight Mode"를 켜고, 동시에 워드프레스 보안 플러그인의 WAF 규칙도 "엄격"으로 올렸다. 두 설정이 겹치면서 구글봇의 요청도 "의심스러운 자동화 트래픽"으로 함께 분류돼 403 응답을 받기 시작했다. 관리자는 몇 주 뒤 순위가 통째로 빠진 뒤에야 원인을 알았다.
좋은 예: 같은 상황에서 관리자가 Bot Fight Mode 대신 검증된 크롤러 허용(Verified Bots Only) 옵션을 켜고, WAF 규칙에는 "검증된 봇은 건너뛰기" 예외를 추가했다. 스팸 트래픽은 여전히 차단되지만 구글봇·빙봇처럼 검증된 크롤러는 정상적으로 통과한다.
진짜 구글봇인지는 어떻게 검증하나?
여기서 흔히 하는 실수가 하나 더 있다. User-Agent 문자열만 보고 "구글봇이니까 통과"라고 판단하는 것이다. User-Agent는 요청을 보내는 쪽이 자유롭게 적을 수 있는 값이라, 스팸 크롤러가 얼마든지 "Googlebot"이라고 자칭할 수 있다. 반대로 이 값을 근거로 접근을 막는 것도 위험하다 — 진짜 구글봇을 걸러낼 수 있기 때문이다.
구글이 공식적으로 권장하는 검증 절차는 역방향 DNS 조회 3단계다.
- 요청이 들어온 IP로 역방향 DNS(host 명령 등) 조회를 실행한다
- 조회된 도메인이
googlebot.com,google.com,googleusercontent.com중 하나인지 확인한다 - 그 도메인을 다시 정방향으로 조회해 원래 IP와 일치하는지 대조한다
예를 들어 서버 로그에 남은 IP가 66.249.66.1이라면, 리눅스·macOS 터미널에서 이렇게 확인한다.
host 66.249.66.1
# 1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
# crawl-66-249-66-1.googlebot.com has address 66.249.66.1
역방향 조회 도메인이 googlebot.com으로 끝나고, 정방향으로 다시 조회했을 때 원래 IP와 정확히 일치해야 진짜 구글봇이다. 두 단계 중 하나라도 어긋나면 구글봇을 사칭한 요청으로 보고 차단해도 된다.
더 간단한 방법은 구글이 공개하는 공식 IP 목록(JSON 파일)을 그대로 방화벽 화이트리스트에 반영하는 것이다. 구글은 크롤러 목적에 따라 common-crawlers.json, special-crawlers.json 등 여러 파일로 IP 대역을 나눠 제공하며, 이 목록은 예전보다 훨씬 잦은 주기로 갱신되고 있다. 방화벽에 IP를 하드코딩해 두면 시간이 지나 목록이 바뀌었을 때 다시 막힐 수 있으므로, 가능하면 이 JSON 파일을 자동으로 불러와 갱신하는 방식을 쓰는 것이 안전하다.
IP 대역을 화이트리스트에 넣을 때는 "지금 한 번" 넣고 끝내지 말 것. 구글의 크롤러 IP는 주기적으로 바뀌므로, 자동 갱신 스크립트나 CDN이 제공하는 "검증된 봇" 옵션을 쓰는 쪽이 유지보수 부담을 줄인다.
클라우드플레어에서는 어떻게 화이트리스트 처리하나?
클라우드플레어 대시보드에서 확인·수정할 위치는 다음과 같다.
- Security > Bots에서 Bot Fight Mode를 끄거나, 프리미엄 플랜이면 Super Bot Fight Mode의 "확실히 자동화된 것" 항목을 차단이 아닌 관리형 챌린지나 허용으로 바꾼다.
- 같은 화면에서 "검증된 봇 허용(Allow Verified Bots)" 옵션이 켜져 있는지 확인한다. 이 옵션이 꺼져 있으면 검증된 검색 크롤러도 다른 규칙에 걸릴 수 있다.
- Security > WAF > Tools의 IP 액세스 규칙을 열어, 구글 소유 IP나 ASN이 차단 목록에 실수로 들어가 있지 않은지 검토한다.
- WAF 관리형 규칙 중 워드프레스·일반 보안 규칙 세트에 검증된 봇에 대한 예외(Exception)를 추가한다.
- 새 도메인이라면 AI 크롤러 차단 기본값에서 "검색(Search)" 목적은 허용, 최소한 구글봇이 걸리는 "학습(Training)" 차단 여부를 다시 검토한다.
수정 후에는 URL 검사 도구의 실시간 테스트로 즉시 확인하고, 크롤링 통계 보고서의 호스트 상태가 며칠 안에 초록으로 돌아오는지 지켜본다. 설정 하나만 고쳤다고 끝난 게 아니라, 실제로 통과가 되는지 반드시 눈으로 재확인해야 한다.
다른 CDN·방화벽에서는 무엇을 봐야 하나?
클라우드플레어 외의 서비스를 쓴다면 이름은 다르지만 구조는 비슷하다.
AWS WAF / CloudFront를 쓴다면 Bot Control 규칙 그룹 안에 "검증된 봇(Verified Bot)" 카테고리가 따로 있다는 점을 기억해 두면 된다. 검색 크롤러는 이 카테고리로 분류되므로, 규칙을 만들 때 이 카테고리는 차단이 아니라 계수(Count)나 허용으로 설정해야 한다. 반대로 "모든 자동화 트래픽 차단" 같은 넓은 규칙을 그대로 적용하면 이 카테고리 구분과 무관하게 함께 막힐 수 있으니, 규칙의 우선순위(어느 규칙이 먼저 적용되는지)도 함께 확인해야 한다.
Akamai Bot Manager도 알려진 검색 크롤러를 별도 카테고리로 인식해 관리할 수 있게 해준다. 일반 봇 방어 정책과 검색 크롤러 정책을 같은 규칙 안에 섞어두지 말고 분리해 두는 것이 안전하다.
Sucuri·Wordfence 같은 워드프레스 보안 플러그인을 쓰는 곳도 많다. 이런 플러그인은 IP 화이트리스트나 "신뢰할 수 있는 크롤러" 목록을 제공하는데, 여기에 구글 IP 대역(또는 역방향 DNS 검증 옵션)을 등록해야 한다. 플러그인을 설치만 하고 기본값을 그대로 둔 경우가 많은데, 기본값이 "엄격"으로 설정된 방화벽 규칙은 검색 크롤러도 함께 걸러내는 경우가 흔하다.
국내 호스팅·솔루션의 보안 설정도 예외는 아니다. 카페24, 아임웹 같은 국내 서비스 대부분은 검색엔진 크롤러를 기본적으로 열어두지만, 별도로 IP 접근 제한이나 국가별 차단(지오블로킹)을 걸어둔 경우 구글 크롤러의 해외 IP까지 함께 막힐 수 있다. 보안을 이유로 특정 국가 이외의 접속을 통째로 막는 설정을 쓰고 있다면, 검색엔진 크롤러 예외를 반드시 함께 확인해야 한다.
나쁜 예: 해외발 스팸 트래픽이 많다는 이유로 특정 국가 IP 대역을 통째로 차단했다. 구글의 크롤링 인프라 일부가 해외 데이터센터 IP를 쓴다는 점을 놓쳐, 결과적으로 크롤링 자체가 줄어들었다.
좋은 예: 국가별 차단을 걸기 전에 검증된 검색 크롤러 예외를 먼저 등록하고, 이후 의심 국가의 나머지 트래픽만 차단했다.
차단을 풀고 나서 무엇을 확인해야 하나?
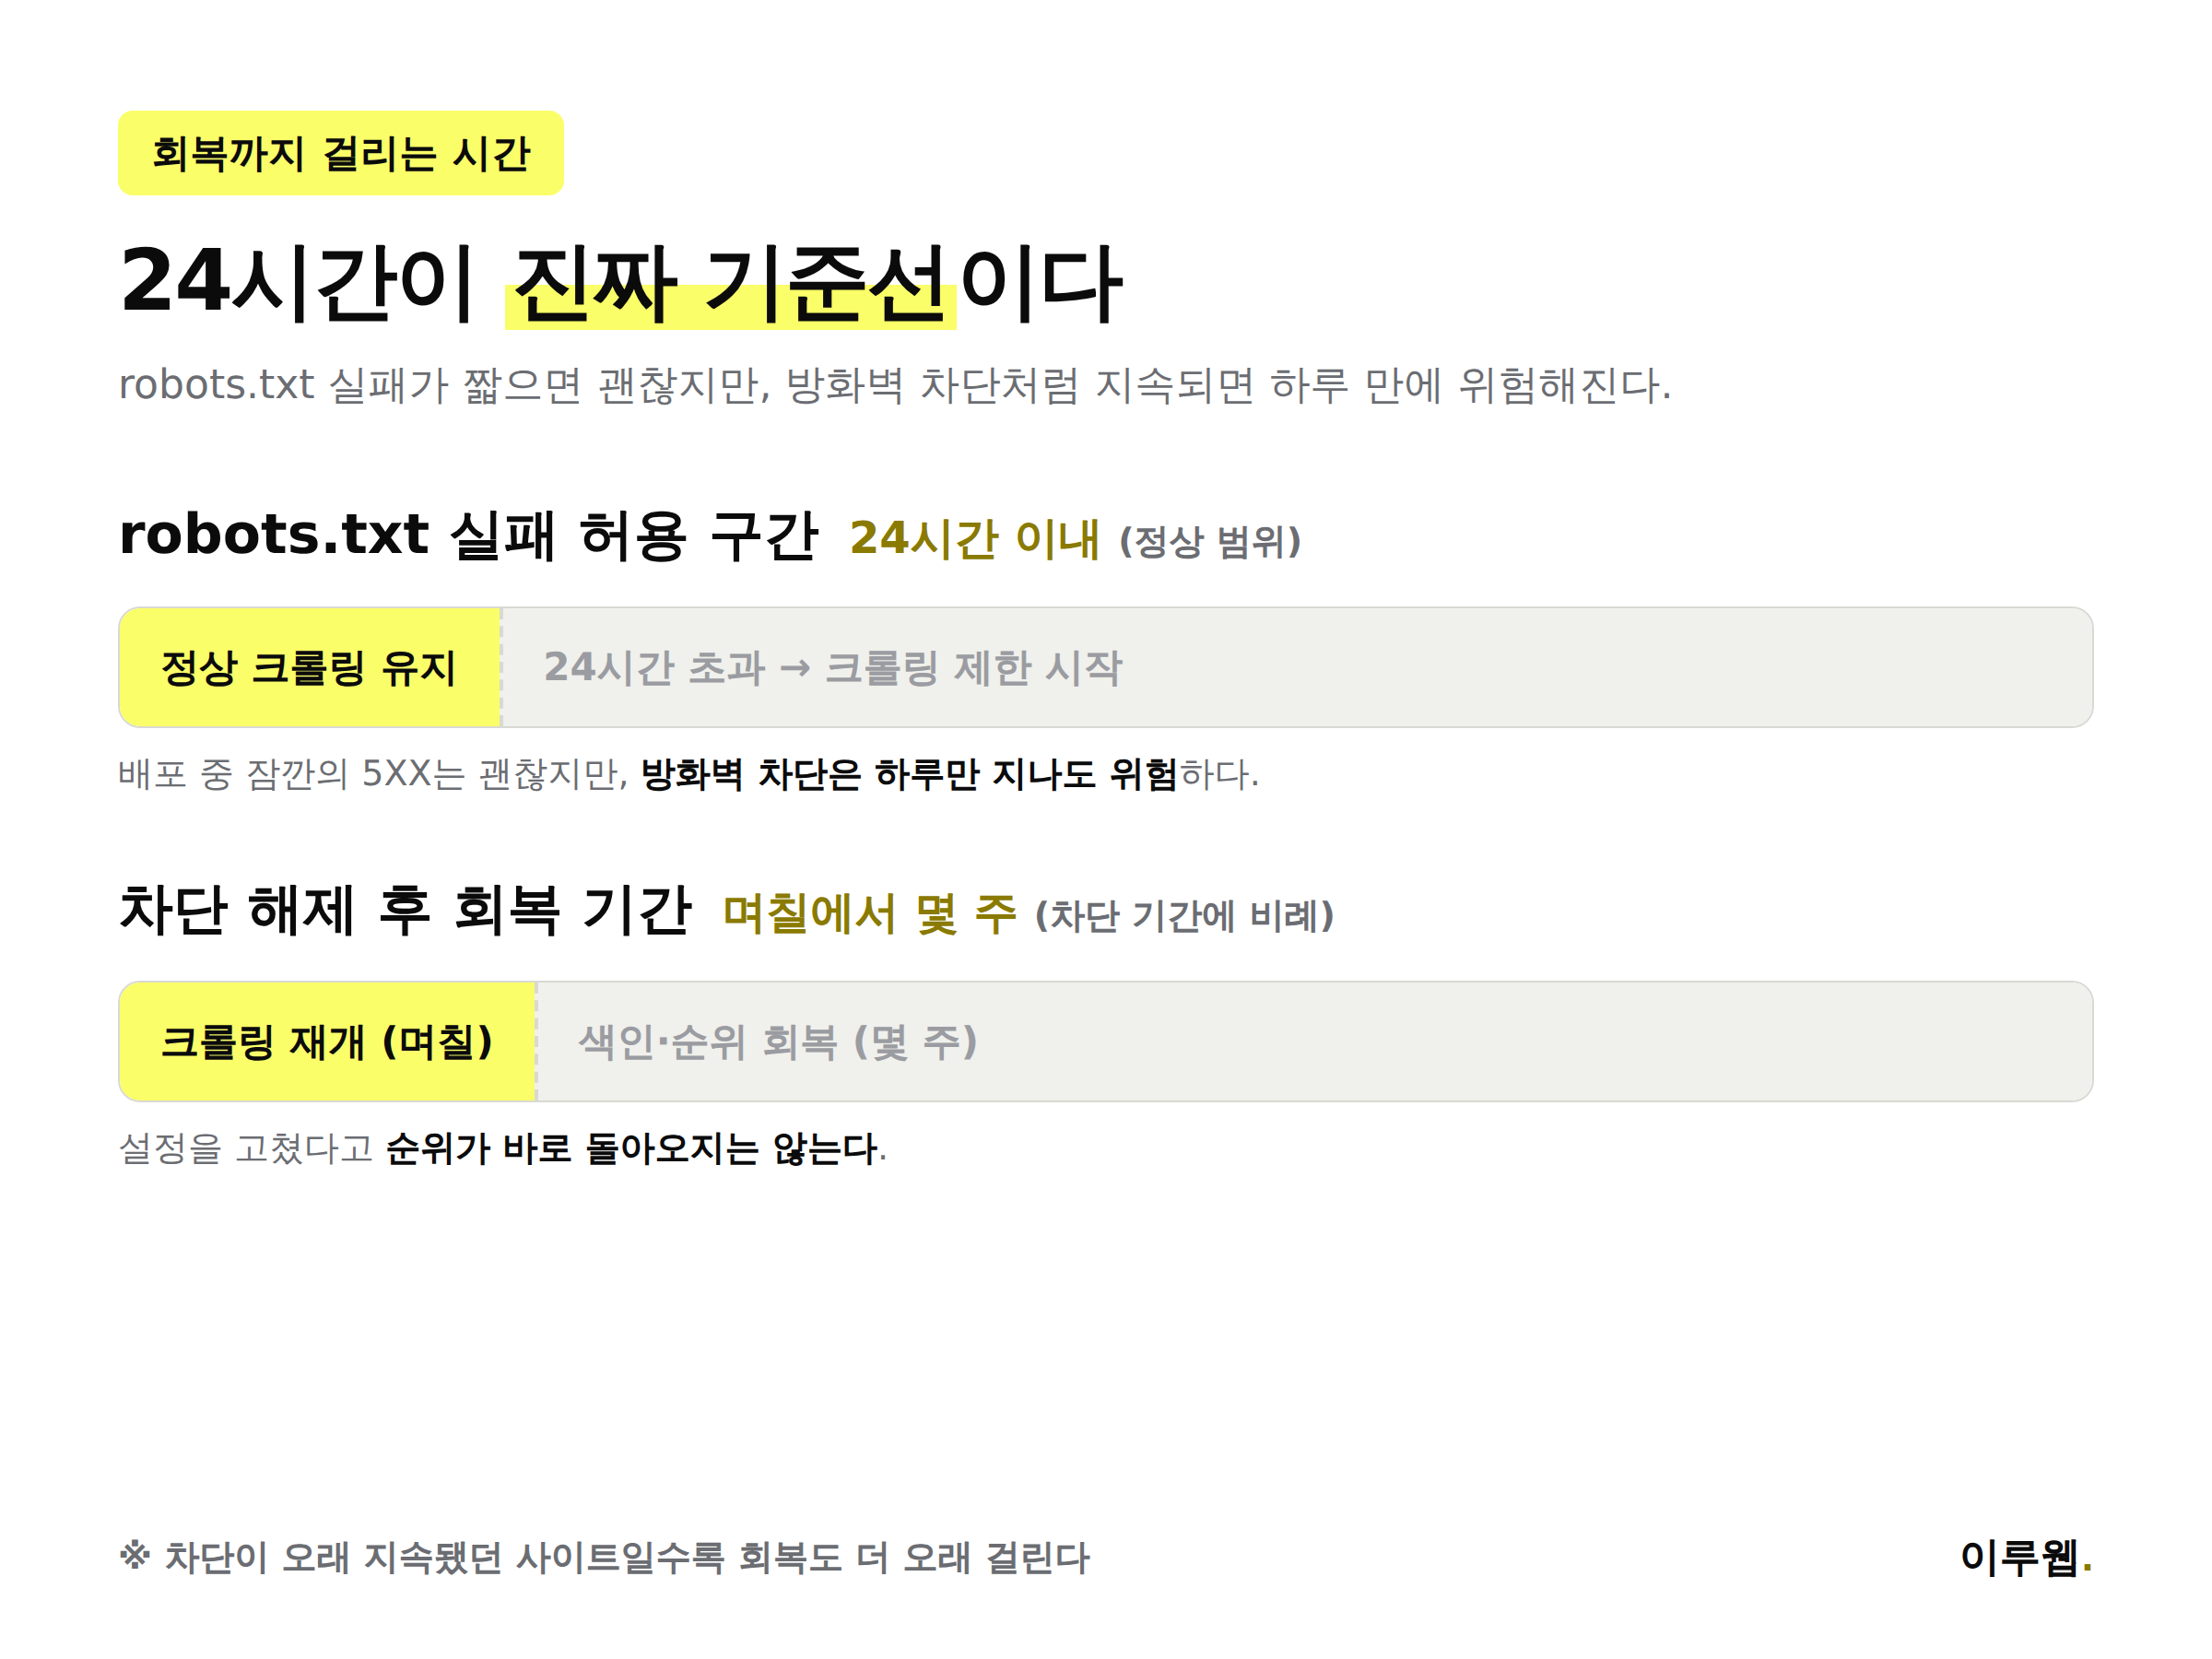
설정을 고쳤다고 순위가 바로 돌아오는 것은 아니다. 구글이 다시 크롤링하고, 색인을 갱신하고, 순위를 재계산하는 데 며칠에서 몇 주가 걸릴 수 있다. 다음 순서로 확인하면 된다.
- URL 검사 도구에서 주요 페이지에 "색인 생성 요청"을 보낸다(전체 사이트를 한 번에 요청하는 기능은 없으므로 핵심 페이지 위주로).
- 사이트맵을 서치 콘솔에 재제출한다.
- 며칠 뒤 크롤링 통계 보고서에서 호스트 상태가 초록으로 바뀌고 크롤링 요청 수가 회복되는지 본다.
- 1–2주 뒤 색인 생성 보고서에서 "크롤됨-현재 색인되지 않음" 페이지 수가 줄어드는지 확인한다.
- 서버 로그에서 실제 구글봇 요청이 다시 늘고 있는지 직접 대조하고 싶다면 구글봇 서버 로그 분석 가이드를 참고한다.
차단이 오래 지속됐던 사이트일수록 회복도 느리다. 구글이 "이 사이트는 자주 막혀 있으니 크롤링 빈도를 낮추자"고 학습한 상태라면, 안정적으로 몇 주간 정상 응답이 이어져야 크롤링 빈도가 다시 올라간다.
정리하면
CDN·방화벽 설정 실수로 인한 구글봇 차단은 화려한 원인이 아니다. 콘텐츠나 백링크, 키워드 전략과는 무관하게, 설정 화면의 토글 하나가 검색 노출 전체를 좌우할 수 있다는 점이 이 문제의 핵심이다. 아무리 좋은 콘텐츠로 홈페이지를 채워도 로봇이 문 앞에서 돌아간다면 그 콘텐츠는 검색 결과에 존재하지 않는 것과 같다.
그래서 순위가 갑자기 전체적으로 빠졌을 때는 콘텐츠를 고치기 전에 크롤링 통계 보고서 → CDN·방화벽 대시보드 → 최근 변경 이력 순서로 먼저 점검하는 습관을 들이는 것이 시간을 아끼는 길이다. 특히 보안 설정을 새로 바꾼 시점과 순위 하락 시점이 겹친다면, 그 설정부터 되돌려 보고 원인을 좁혀가는 것이 순서다.
자주 묻는 질문
구글봇 차단이 몇 시간이나 지속되면 위험한가?
robots.txt에 대한 접근 실패가 24시간을 넘기면 구글이 스스로 크롤링을 제한하기 시작한다. 짧은 순간의 오류(배포 중 몇 분간의 5XX 등)는 대체로 큰 영향이 없지만, 방화벽 설정처럼 지속적인 차단은 하루만 지나도 크롤링 감소로 이어질 수 있다.
IP 차단과 User-Agent 차단은 무엇이 다른가?
User-Agent 차단은 요청 헤더의 이름표만 보고 걸러내는 방식이라 위조가 쉽고, 진짜 구글봇을 놓치거나 가짜 봇을 통과시키는 오류가 함께 생긴다. IP 기반 검증(공식 IP 목록 또는 역방향 DNS)은 더 신뢰할 수 있지만, 구글의 IP 대역이 갱신되므로 목록을 계속 최신 상태로 유지해야 한다.
화이트리스트 처리 후 순위가 바로 회복되나?
아니다. 크롤링이 정상화되는 데 며칠, 색인과 순위가 눈에 보이게 회복되는 데 몇 주가 걸리는 경우가 흔하다. 차단 기간이 길었다면 회복도 더 오래 걸린다고 보는 것이 현실적이다.
네이버도 CDN 설정 때문에 같은 문제가 생기나?
원리는 비슷하지만 확인 방법이 다르다. 자체 도메인으로 운영하는 홈페이지라면 네이버 서치어드바이저의 수집 현황에서 비슷한 방식으로 확인할 수 있다. 다만 네이버 블로그(blog.naver.com)는 네이버가 자동으로 수집·색인하므로 별도의 방화벽·CDN 설정이 개입할 여지가 거의 없다. 이 글의 내용은 자체 도메인 홈페이지·쇼핑몰처럼 CDN·방화벽을 직접 두는 환경에 해당한다.
개발 서버나 스테이징 사이트는 일부러 구글봇을 막아도 되나?
그렇다. 오히려 막아야 하는 경우다. 다만 이때도 robots.txt 차단만으로는 이미 들어간 URL이 색인에서 완전히 빠지지 않을 수 있으므로, HTTP 기본 인증을 추가로 걸거나 noindex 메타 태그를 함께 쓰는 것이 안전하다. 이 글에서 다룬 내용은 "의도치 않은" 실서비스 차단에 대한 것이며, 스테이징 환경을 막는 것과는 목적이 다르다.
CDN을 쓰는 것 자체가 SEO에 불리한가?
아니다. 오히려 반대다. CDN은 페이지 로딩 속도를 높여주는 요소로, 속도는 구글의 정식 순위 요인 중 하나다. 문제는 CDN이 아니라 그 안에 포함된 봇 방어 기능의 세부 설정이다. CDN을 끄는 것은 해결책이 아니고, 봇 방어 규칙에서 검증된 검색 크롤러를 예외로 등록하는 것이 올바른 방향이다.
이런 문제를 매번 수동으로 확인해야 하나?
매일 대시보드를 들여다볼 필요는 없다. 서치 콘솔에서 호스트 상태에 심각한 문제가 생기면 이메일로 알림을 보내주므로, 이 알림을 놓치지 않는 것만으로도 상당수 사고를 조기에 잡을 수 있다. 여기에 더해 보안 설정을 바꾸는 시점마다 URL 검사 도구로 한 번씩 실시간 테스트를 해보는 습관을 들이면, 사고가 나더라도 몇 주가 아니라 몇 시간 안에 원인을 찾을 수 있다.
CDN·방화벽 설정은 한 번 잘못 건드리면 원인을 찾기까지 시간이 걸리고, 그 사이 순위와 트래픽이 함께 빠지는 항목입니다. 저희 이루웹은 홈페이지를 만들 때부터 이런 크롤링 차단이 생기지 않도록 SEO 최적화 홈페이지 제작 단계에서 CDN·보안 설정까지 함께 점검해 드리고 있습니다. 이미 운영 중인 사이트에서 갑작스러운 순위 하락을 겪고 계시다면, 원인 진단부터 도와드릴 수 있으니 이루웹의 다른 서비스도 살펴보시고 편하게 문의 남겨 주시기 바랍니다.
함께 보면 좋은 글
전체 보기유니버설 커머스 프로토콜(UCP) 완벽 가이드
구글 쇼핑 결제의 새 표준 유니버설 커머스 프로토콜(UCP)을 개념부터 체크리스트까지 정리했습니다. 쇼핑몰이 지금 점검할 것도 담았습니다.
22분 분량구글 서치 센트럴 라이브, 인도 벵갈루루서 다시 연다
3년 만에 다시 열리는 인도 서치 센트럴 라이브, 오프라인 전용 행사지만 다뤄질 의제는 국내 실무자에게도 의미가 있습니다.
5분 분량구글 서치 센트럴 라이브, 올해는 바르셀로나
구글이 첫 유럽 딥다이브 행사를 9월 30일부터 바르셀로나에서 엽니다. 신청은 마감됐지만, 사흘 커리큘럼이 보여주는 우선순위를 정리했습니다.
4분 분량구글 애드센스, 본인 인증 기준이 0달러로 낮아졌다
구글 애드센스가 2026년 6월부터 본인 인증 기준을 0달러로 낮췄습니다. 신규 계정은 개설 직후 신원 확인부터 마쳐야 광고를 게재할 수 있습니다.
5분 분량